Recherche
1. Le projet en bref
Lettres de Calvin présente une édition critique numérique bilingue de la correspondance en français du réformateur Jean Calvin pendant la période de 1538 à 1554. Le but est de présenter une infrastructure dynamique de recherche accessible et exploitable pour un public autant francophone qu’hispanophone.
L’édition se concentre sur les lettres écrites par Calvin en français. Elle propose des fonctionnalités pour l’exploration transversale et dynamique de la correspondance, ainsi que la comparaison de plusieurs états du texte des lettres, notamment la source primaire, manuscrite ou imprimée, le texte de l’édition de Jules Bonnet de 18541, une version modernisée et une traduction espagnole. Elle permet aussi d’étudier et de comparer la transcription diplomatique d’une sélection des manuscrits autographes avec le texte de l’édition Bonnet, qui représente, dans la plupart des cas, l’état éditorial suivant dans l’histoire éditoriale de la lettre. À ce jour, l’édition —encore en cours— donne accès à 27 lettres sur les 120 lettres qui composent le corpus établi.
L’édition prend l’édition Bonnet de 1854 comme texte de référence en mobilisant également les sources primaires, dont 113 sont manuscrites. La majorité des sources primaires manuscrites —soit 97 sur 113— ont été conservées à la Bibliothèque de Genève. (Voir le carnet de données (notebook) Recensement du corpus de sources primaires de la correspondance de Calvin pour un recensement plus détaillé des sources primaires composant le corpus.)
2. Corpus, périmètre et sources
Le corpus établi est composé de 120 lettres écrites par Calvin en français de 1538 à 1554. L’édition se concentre pour le moment sur les lettres envoyées par Calvin car peu de lettres reçues par le réformateur ont été conservées.
Les témoins mobilisés par l’édition numérique sont donc le premier volume de l’édition de Jules Bonnet de 1854, servant d’édition de référence, et les manuscrits autographes, les minutes, les copies anciennes et les éditions imprimées anciennes qui servent de sources primaires. Les manuscrits conservés à la Bibliothèque de Genève sont rendus disponibles au moyen des liens ARK (Archive Resource Key). L’édition Bonnet et les manuscrits conservés sur Gallica, la plateforme numérique de la Bibliothèque nationale de France (BnF) sont, à leur tour, rendus disponibles au moyen du protocole IIIF (International Image Interoperability Framework). Les liens ARK et IIIF permettent de charger et d’afficher ces facsimilés sur l’interface de l’édition directement depuis l’institution de conservation et en haute qualité. Les autres sources primaires et les éditions imprimées anciennes, qui constituent environ 15% du total des sources primaires disponibles, sont hébergés sur le serveur du projet au format image (JPG ou PNG) de haute qualité.
Le critère retenu pour établir le corpus est la disponibilité numérique de la source primaire de la lettre. C’est pourquoi 120 lettres sur les 124 lettres que comprend l’édition Bonnet, qui sert d’édition de référence, composent le corpus de cette édition numérique. Les sources primaires des quatre lettres suivantes demeurent introuvables :
- Lettre aux Seigneurs de Genève de [mai 1550]
- Lettre à Christophe et à Thomas Zollicoffre du 28 mars 1553
- Lettre aux fidèles des Iles du 12 octobre 1553
- Lettre aux Seigneurs de Berne du 4 octobre 1554
Par conséquent, ces quatre lettres ont été exclues de l’édition numérique. Bien que seulement quatre lettres soient exclues du corpus à cause de l’indisponibilité de leur source primaire, certaines métadonnées des lettres sont reconstituées, notamment certaines dates —lorsqu’elles ne sont pas explicitement indiquées— et les lieux de destination des lettres. Ces informations sont généralement inférées à partir du contexte de la lettre, à partir du contexte plus large du réseau de correspondance, ainsi qu’à partir de sources historiques externes, y compris les lettres latines de Calvin —information souvent héritée de l’édition Bonnet. Lorsque le niveau de certitude concernant une information est moyen ou faible, l’information en question est placée soit entre parenthèses —notamment le texte hérité de l’édition Bonnet— ou entre crochets, et l’inférence est expliquée dans l’annotation correspondante.
3. Principes éditoriaux et états du texte
Chaque lettre est présentée dans un apparat critique qui offre quatre modes de consultation et états du texte :
- Source primaire : facsimilés du manuscrit, de la minute, de la copie manuscrite ou de l’édition imprimée ancienne, accompagnés de l’information de catalogue de l’institution de conservation.
- Édition Bonnet : facsimilés et transcription numérique de l’édition Bonnet de 1854, dont l’état linguistique et l’organisation textuelle sont conservés, à l’exception de la pagination.
- Version modernisée et annotée : modernisation principalement orthographique et lexicale, la syntaxe étant conservée afin de garder le ton et le style de l’auteur et de son époque, annotations contextuelles et textuelles, et distinction entre annotations de Bonnet et annotations nouvelles (en vert) ; une version comparateur montre les modifications apportées au texte de l’édition Bonnet.
- Traduction espagnole : traduction de la version modernisée, alignée approximativement par paragraphes au moyen d’un défilement synchronisé.
Une seconde interface comparative, consacrée à une sélection de lettres, est disponible dans l’interface française et aussi accessible depuis l’interface espagnole :
- Transcription diplomatique du manuscrit autographe : disponible pour une sélection de manuscrits autographes, représentative de la variété des manuscrits et servant d’appui pour certaines des annotations textuelles ; cette transcription diplomatique et sa comparaison avec le texte de l’édition Bonnet permettent l’étude des pratiques paléographiques, de transcription, de régularisation et de développement d’abréviations. (Voir le protocole de transcription)
Protocole éditorial et modèle d’encodage
L’édition numérique s’appuie sur un modèle d’encodage TEI (Text Encoding Initiative) adapté aux correspondances, développé par le TEI Correspondence SIG (Special Interest Group on Correspondence)2.
Structure basique des lettres
- L’ouverture (
<opener>) contenant :- L’adresse du destinataire (
<address>qui contient aussi<addrLine>) - La date et le lieu (
<dateline>) - L’appel (
<salute>)
- L’adresse du destinataire (
- Le corps de la lettre structuré en paragraphes
- La partie finale (
<closer>) contenant :- La date et le lieu (
<dateline>) - La salutation finale (
<salute>) - La signature (
<signed>)
- La date et le lieu (
Métadonnées de la lettre
- Les informations relatives au fichier, telles que le titre et le nom de la personne responsable de l’édition, figurent dans l’élément <titleStmt>.
- Les informations relatives à la publication figurent dans l’élément
<publicationStmt>. - La description des sources, à l’intérieur de l’élément
<sourceDesc>, comprend aussi les éléments suivants :<msDesc>pour les informations principales des sources primaires,majoritairement manuscrites<facsimile>pour donner accès aux facsimilés de l’édition Bonnet et des sources primaires
- Les informations qui décrivent la correspondance comme événement sont encodées au moyen des éléments
<profileDesc>,<correspDesc>,<correspAction>et<correspContext>. L’élément<desc>est utilisé pour fournir un résumé de présentation de la lettre et l’élément<term>, en tant qu’élément enfant de<list>, est utilisé pour les mots-clés thématiques de la lettre.
Modernisation et annotations
- La modernisation du français du XVIe siècle, à la fois pour fournir une version plus accessible à un lectorat moderne et pour conserver de façon visible l’évolution du texte d’une édition à l’autre, est encodée au moyen de la balise
<choice>avec ses éléments enfants<orig>et<reg>—ou<sic>et<corr>pour la correction d’erreurs détectées dans le texte. - Les balises
<persName>,<placeName>,<orgName>, et<title>—<biblpour des références plus complètes et structurées— sont aussi mobilisées pour l’encodage des entités nommées, reliées à la base de connaissances Wikidata —ou à la source consultable en ligne, si elle existe, pour les titres d’ouvrage mentionnés ; les entités nommées pour les destinataires et les lieux d’envoi et de destination des lettres sont également reliées à leur index respectifs, soit l’index de noms ou de lieux.- Le lieu de destination de la lettre, étant une information qui est rarement indiquée explicitement dans la lettre, est généralement inféré d’après le contexte de la lettre ainsi que d’après des sources externes à la correspondance. Il existe toutefois des cas où le lieu de destination est implicite et évident d’après l’appellation même du ou des destinataire(s) de la lettre, ex. à l’église de Genève, aux seigneurs de Neuchâtel, aux fidèles de Lyon. L’information sur le lieu de destination est placée dans
<correspAction type="received">avec<settlement>et également avec les informations d’ouverture à l’intérieur de la balise<dateline>avec<placeName>.
- Le lieu de destination de la lettre, étant une information qui est rarement indiquée explicitement dans la lettre, est généralement inféré d’après le contexte de la lettre ainsi que d’après des sources externes à la correspondance. Il existe toutefois des cas où le lieu de destination est implicite et évident d’après l’appellation même du ou des destinataire(s) de la lettre, ex. à l’église de Genève, aux seigneurs de Neuchâtel, aux fidèles de Lyon. L’information sur le lieu de destination est placée dans
- Les citations des passages en latin dans le texte sont encodées au moyen d’une balise
<hi xml:lang="lat" rend="italic">passage ou citation en latin</hi>suivies d’une annotation contenant la traduction :<note n="#" type="tradLat" place="bottom"><p>Traduction du passage en latin</p></note>. - Les annotations de cette édition numérique sont distinguées des annotations de Bonnet au moyen de la valeur ‘editorial’ de l’attribut
@typede l’élément<note>, ainsi que par l’indication explicite [Note éditoriale] à la fin de la note. Les notes éditoriales sont également rendues en vert.- Si une lettre est citée à l’intérieur d’une note, la lettre citée sera encodée en utilisant les éléments de la structure basique d’une lettre :
<opener>,<p>et<closer>à l’intérieur de l’élément<note>correspondant. - Si une annotation de Bonnet est éditée, l’ajout ou la suppression sont faits au moyen des éléments
<add type='editorial'>ou<del>respectivement. - Si une note comprend des citations en latin, les passages latins cités et leurs traductions sont encodés comme suit :
- Si une lettre est citée à l’intérieur d’une note, la lettre citée sera encodée en utilisant les éléments de la structure basique d’une lettre :
<hi xml:lang="latinq" rend="italic">passage ou citation en latin</hi>
<hi xml:lang="trad">[traduction]</hi>
Le protocole éditorial de la traduction espagnole est similaire, à l’exception de l’emploi des balises <choice> et des éléments enfants de la balise <sourceDesc>, étant donné que la traduction espagnole ne comporte pas de modernisation et qu’elle prend pour source la version modernisée établie de la lettre en français. La correspondance entre la lettre en français et sa traduction espagnole —aussi utilisée pour la correspondance français-espagnol de l’interface de l’édition— est établie au moyen de l’attribut @xml:id de l’élément <TEI> du fichier XML-TEI en français et de l’attribut @corresp de l’élément <sourceDesc> du fichier XML-TEI de la traduction espagnole.
Dans le fichier XML-TEI en français :
<TEI xmlns='http://www.tei-c.org/ns/1.0' xml:lang="fr" xml:id="Destinataire_annee_mois">Dans le fichier XML-TEI en espagnol :
<sourceDesc corresp="Destinataire_annee_mois"> …
</sourceDesc>
Consultez les modèles d’encodage en français et en espagnol pour plus de détails.
4. Protocole de travail
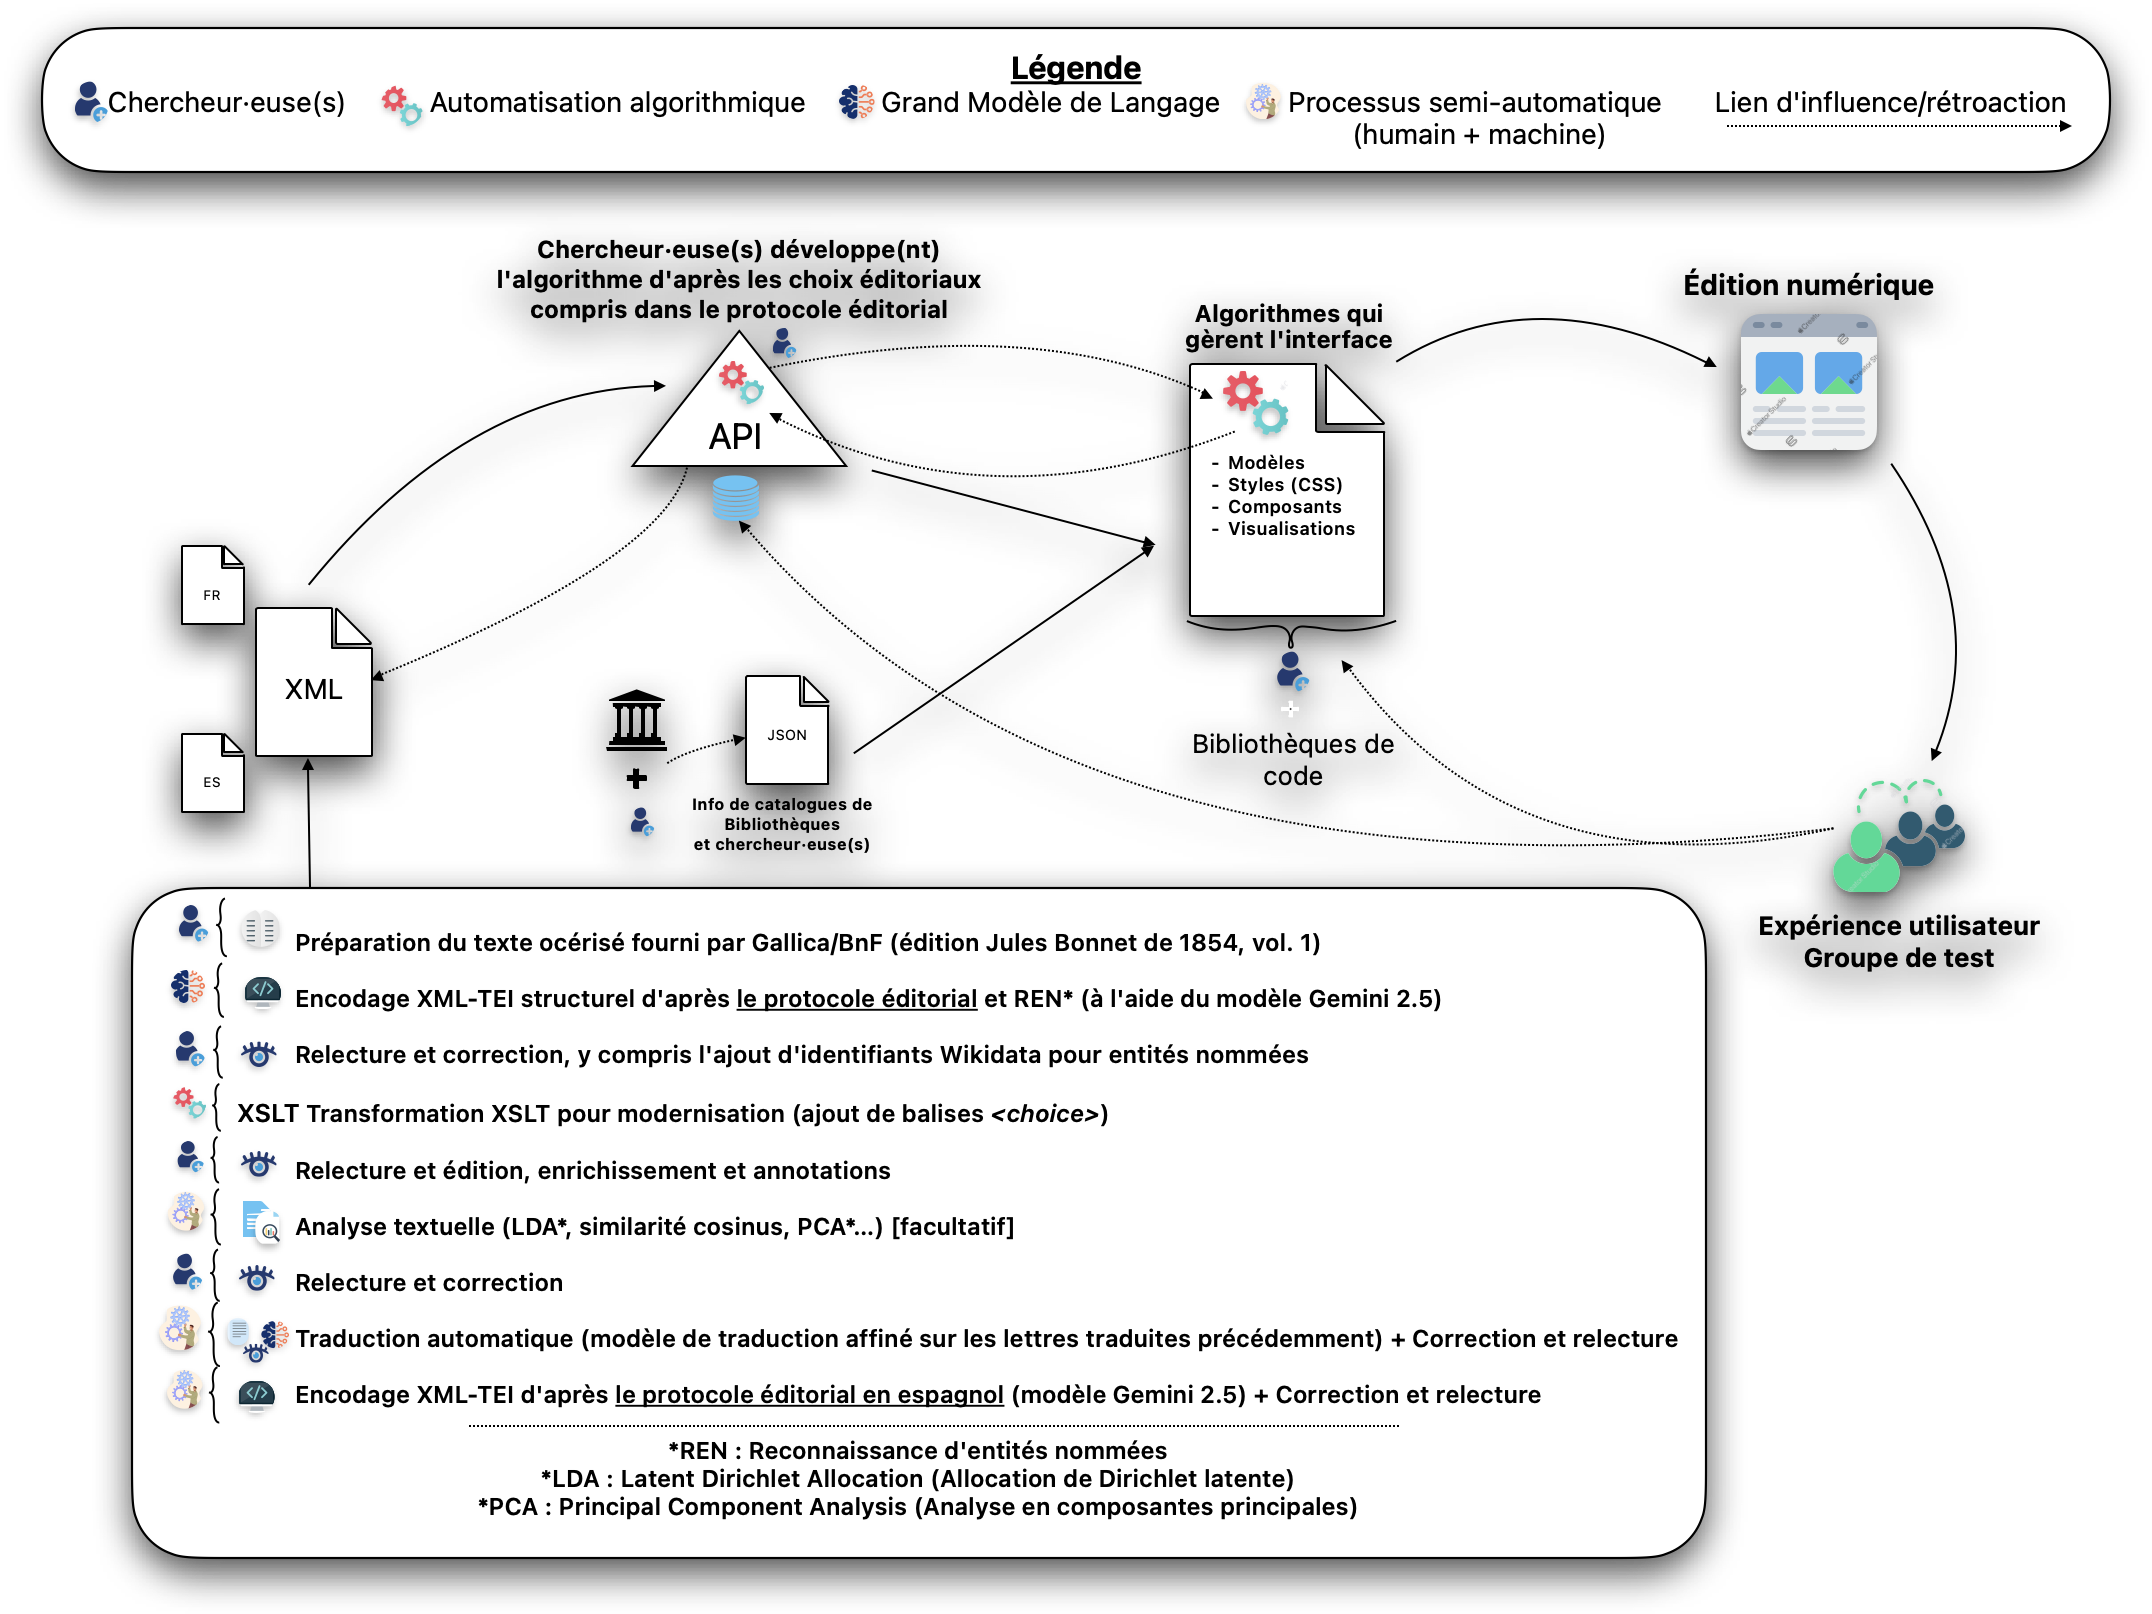
5. Données, technologies et semi-automatisation
- Données structurées : XML-TEI, identifiants stables, métadonnées et relations entre lettres, personnes, lieux et sources.
- Traitements semi-automatisés : encodage structurel basique et reconnaissance d’entités nommées, modernisation —ajout de balises
<choice>, extraction des mots-clés thématiques (facultatif), requêtes SPARQL via le point d’accès SPARQL de Wikidata, génération d’index, publication de plusieurs vues à partir des mêmes données et aide au repérage d’incohérences. - Supervision humaine : vérification philologique, validation des métadonnées, révision de la modernisation et de la traduction, documentation des décisions.
6. Contrôle qualité, incertitude et transparence
Les processus semi-automatisés imposent certaines normalisations et permettent ainsi d’identifier des erreurs plus facilement. Par ailleurs, certains contrôles de l’interface permettent de repérer des erreurs d’encodage, d’alignement, de liens et de métadonnées afin de les corriger. Par exemple, si la traduction espagnole ne s’affiche pas, mais la version modernisée utilisée comme alternative par défaut ou la traduction d’une autre lettre, cela indique une erreur d’alignement dans l’encodage. L’automatisation contribue ainsi à la production et au contrôle de l’édition, mais elle ne remplace ni l’interprétation ni la responsabilité éditoriale.
Concernant les informations incertaines de date, lieu ou identité, elles sont signalées avec transparence au moyen de parenthèses —héritées de Bonnet— et des crochets. Des annotations documentent et expliquent la justification d’une hypothèse et, lorsque possible, fournissent la source de l’information. Dans les visualisations, notamment dans la visualisation cartographique, des codes couleurs signalent aussi des informations incertaines et la légende en explique les détails.
De plus, les interventions éditoriales concernant la modernisation ainsi que les ajouts et les suppressions restent visibles dans la version comparateur de versions. Les ajouts et les mots ou phrases courtes modernisées sont soulignées en vert. Le texte original de l’édition Bonnet qui a été modernisé et le texte supprimé ou corrigé est barré en rouge.
7. Usages scientifiques et limites
Cette édition permet ainsi l’étude des pratiques éditoriales et de transmission textuelle, ainsi que l’analyse de la langue, la traduction et le réseau de correspondance de Calvin, particulièrement à travers la navigation transversale par lieux, personnes, catégories et thèmes.
Cependant, les visualisations et les index proposent des parcours et des hypothèses sur le corpus qui ne constituent pas de preuves historiques autonomes. Les résultats des analyses doivent toujours être rapportés aux lettres, aux métadonnées et aux sources.
8. Documentation, données et crédits
Vous pouvez consulter la documentation et les données sur les dépôts GitHub du projet : Process Docs pour la chaîne éditoriale de traitement et Lettres de Calvin pour la publication et gestion de l’interface.
Voici une liste plus détaillée des données :
- Protocole éditorial et d’encodage détaillé en français et en espagnol.
- Schéma personnalisé XML-TEI.
- Documentation et conditions de réutilisation : consultez notamment les fichiers README de chaque dépôt ; certaines instructions plus détaillées se trouvent dans les fichiers de code ou d’instruction respectifs. Les données et l’édition sont en libre accès. Les contributions sont bienvenues. Les données et le code peuvent être réutilisés sous attribution.
- Toutes les données sont téléchargeables et chaque version stable est archivée sur Zenodo.
Citations recommandées :
- Lettres de Calvin : Calvin, Jean. Lettres de Calvin. Édité par Yanet Hernández Pedraza. Université de Montréal, 2025. Édition numérique. https://lettres-calvin.netlify.app/fr.
- Dépôts GitHub :
- Hernández Pedraza, Y. (2026). Lettres de Calvin (Version v1.4) [Computer software]
- Hernández Pedraza, Y. (2026). Process Docs (Version v1.0.4) [Data set]
- Versions archivées sur Zenodo :
- Hernández Pedraza, Yanet. Lettres de Calvin. V. 1.4. Zenodo, archivé le 18 septembre 2026. https://doi.org/10.5281/zenodo.22822414.
- Hernández Pedraza, Yanet. « Process Docs ». Processus éditorial. V. 1.0.4. Zenodo, 18 septembre 2026. https://doi.org/10.5281/zenodo.22826915.
Crédits
Ce projet s’inscrit dans la recherche doctorale de Yanet Hernández Pedraza, menée à l’Université de Montréal.
Auteure du projet : Yanet Hernández Pedraza
Co-directeurs de recherche : Michael E. Sinatra (Université de Montréal) et Dario Brancato (Université Concordia)
Institution académique : Université de Montréal
Financement : Groupe de recherche sur les éditions critiques en contexte numérique (GREN), le Fonds de recherche du Québec et les Études supérieures et postdoctorales (ESP) de l’Université de Montréal.
Notes
1Calvin, Lettres de Jean Calvin : lettres françaises.
2Voir Stadler et al., « Towards a Model for Encoding Correspondence in the TEI ».
Références
Calvin, Jean. Lettres de Jean Calvin : lettres françaises. T. 1 / recueillies pour la première fois et publ. d’après les ms. originaux par Jules Bonnet. Édité par Jules Bonnet. 1 vol. Lettres de Jean Calvin. Librarie de Ch. Meyrueis et compagnie, 1854. https://gallica.bnf.fr/ark:/12148/bpt6k209248w.
Stadler, Peter, Marcel Illetschko, et Sabine Seifert. « Towards a Model for Encoding Correspondence in the TEI: Developing and Implementing <correspDesc> ». Journal of the Text Encoding Initiative, no Issue 9 (septembre 2016): Issue 9. https://doi.org/10.4000/jtei.1433.
Protocole de transcription de l’écriture de Jean Calvin
Voyelles nasales : ā ē ī ō ū
Conserver les s longs ( ʃ )
Le symbole ᴖ indique le signe d’abréviation utilisé dans le manuscrit. Dans les manuscrits, un symbole semblable est placé au-dessus des lettres du mot abrégé. Le mot abrégé comprend généralement sa première lettre suivie de ses deux dernières lettres. Étant donné que c’est difficile de transcrire ce symbole, le symbole ( ᴖ ) est donc placé entre la première lettre et les deux dernières lettres du mot abrégé pour indiquer les lettres manquantes.
Exemples :
 q⁀
 n⁀re
 f⁀re
 Dans ce cas-ci, le symbole superindexé se transcrit par son équivalent, c’est-à-dire « ur ». Donc, la transcription correspondante est « leur ».
 nous
 plus
Dans ces cas-ci, le symbole signalé représente l’abréviation « us ». Ils sont ainsi transcrits par « nous » et « plus » respectivement.
 Ce symbole représente l’abréviation de « par, per». Il se transcrit donc par « ꝑ », appelé « p barré à travers la descendante ».
 Quant au texte barré, comme dans l’exemple ci-dessus, il se transcrit comme suit : ̶d̶e̶ (si lisible) ; --- (si illisible)
 Ce symbole se transcrit par « & » (esperluette).
 Ce symbole se transcrit par « - » (tiret de césure).
Référence
Sabot, Thierry. 2004. « Paléographie : La forme des lettres ». Histoire-Généalogie. août 2004. https://www.histoire-genealogie.com/Paleographie-La-forme-des-lettres?lang=fr.